PDF, Word, TXT o Markdown para una IA: qué formato usar y cómo prepararlo
Respuesta rápida: elige por lo que debe sobrevivir
La extensión del archivo no garantiza que una IA vea todo lo que tú ves. Antes de exportar, pregúntate qué información no puede perderse: ¿solo el texto?, ¿los encabezados?, ¿una tabla?, ¿la relación entre una imagen y su pie?, ¿la posición visual?, ¿o la posibilidad de seguir editando?
Qué formato preparar según la información que necesitas conservar
| Si tu tarea depende de… | Punto de partida | Qué comprobar antes de confiar |
|---|---|---|
| Prosa lineal, transcripción o registros simples | TXT | Codificación UTF-8, separadores claros y orden |
| Encabezados, listas, enlaces y una estructura textual auditable | Markdown | Que la función admita .md o permita pegarlo y que entienda el dialecto usado |
| Tablas, listas, estilos y edición posterior | Word (DOCX) | Qué elementos extrae la herramienta y si hay objetos flotantes, comentarios o cambios pendientes |
| Página final, diagrama, gráfico o posición visual | Texto seleccionable, orden de lectura y análisis visual en esa función concreta | |
| Comparar versiones o revisar cambios de texto | TXT o Markdown | Que la conversión no haya eliminado contenido necesario |
| Compartir un documento cerrado que también debe conservar su apariencia | PDF, más una versión textual si hace falta | Que el texto, las tablas y los elementos visuales importantes sean recuperables |
No es una clasificación de “mejor a peor”. Un TXT puede ser la opción más fiable para una transcripción y la peor para interpretar un gráfico. Un PDF etiquetado puede contener estructura y orden lógico; un PDF escaneado puede ser solo una imagen hasta que se aplique OCR. Y una tabla con barras verticales no pertenece al núcleo de todo Markdown: depende del dialecto o del procesador.
Que se pueda subir no significa que se interprete bien
Conviene separar cuatro capas que suelen mezclarse:
- Admisión: la función acepta la extensión y el tamaño del archivo.
- Extracción: obtiene texto, imágenes, tablas u otros objetos.
- Preservación: conserva las relaciones que importan, como el orden, la jerarquía o qué pie corresponde a qué figura.
- Respuesta correcta: usa esa representación para resolver bien tu tarea.
Cada capa necesita una comprobación distinta. Que un PDF termine de cargarse solo prueba admisión. Que puedas encontrar una frase prueba que hay texto recuperable, pero no que un gráfico, una nota al pie o dos columnas hayan entrado en el orden correcto. Y extraer todo tampoco garantiza una respuesta correcta del modelo.
Por eso, una lista comercial de “formatos compatibles” sirve para saber por dónde empezar, no para decidir qué formato siempre entiende mejor una IA.
La prueba local: el mismo documento en cuatro formatos
Para hacer visibles esas diferencias preparamos Proyecto Faro, un acta completamente ficticia. Su fuente de verdad es un archivo fixture.json con nueve unidades ordenadas: título y aviso, objetivo, pasos, matriz, referencia, nota, imagen, pie y cierre. Desde esa fuente generamos Word (DOCX), TXT y Markdown; el PDF se exportó desde el DOCX con Microsoft Word.
El documento incluye una lista numerada, una tabla, un enlace y un diagrama con texto alternativo y pie. Los nombres, estados y cifras son inventados. No contiene documentos de usuarios ni resultados de modelos.
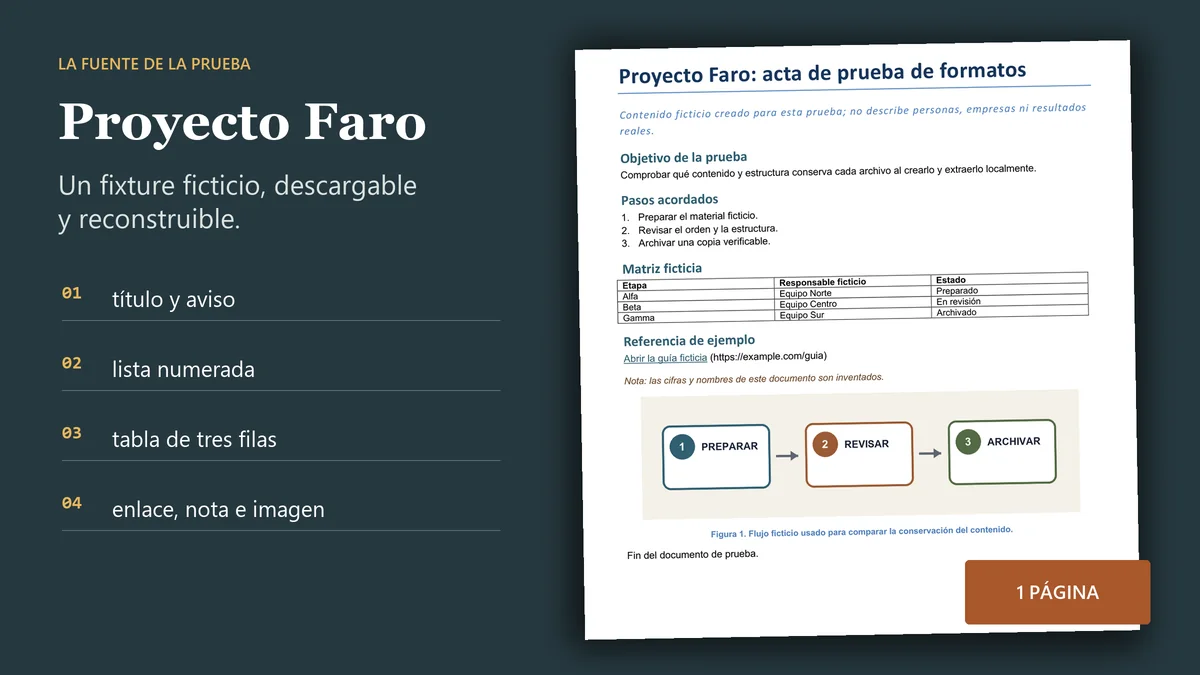
Puedes auditar o repetir la prueba sin subir un documento propio:
- Descargar el paquete completo con los cuatro formatos.
- Revisar el manifest con hashes, herramientas y resultados.
- Abrir por separado el DOCX, el PDF, el TXT o el Markdown.
La cadena local usó un extractor apropiado para cada representación: estructura OOXML para DOCX, PyMuPDF y una observación secundaria de tablas con pdfplumber para PDF, lectura UTF-8 estricta para TXT y un render CommonMark con extensión de tablas GFM para Markdown. Esto compara archivos y extractores locales; no compara ChatGPT, Gemini, Claude, Copilot ni otro modelo.
Qué significan las etiquetas
PASS: el criterio previsto se observó con el método indicado.EXPECTED_FORMAT_LOSS: el formato no representa ese objeto como tal, aunque pueda conservar su descripción textual.EXTRACTOR_LIMIT: el extractor usado no expuso la propiedad; eso no demuestra que el archivo carezca de ella.FAIL: faltó contenido o una propiedad exigida. El manifest final no registró fallos.
Qué preservaron los cuatro artefactos
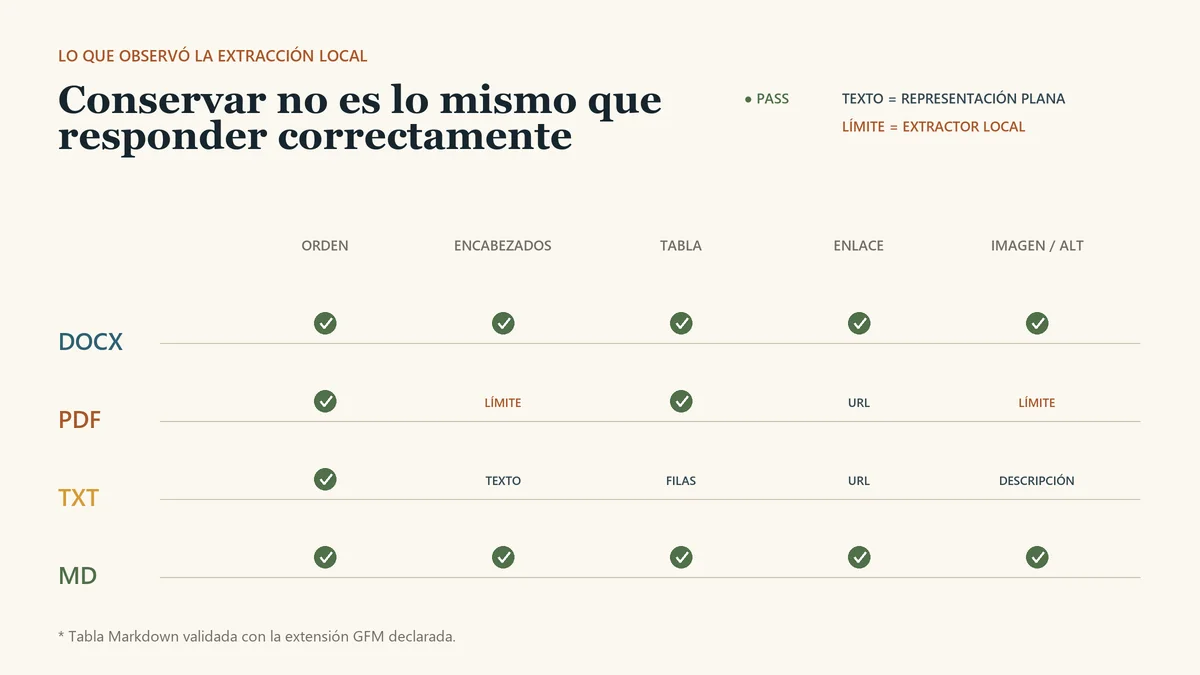
Los cuatro conservaron las nueve unidades de contenido en el orden esperado. Las diferencias aparecieron en cómo representaron la estructura, no en una supuesta puntuación de inteligencia.
Resultados observados en el fixture local Proyecto Faro
| Formato | Resultado observado | Pérdida esperada o límite |
|---|---|---|
| DOCX | PASS: encabezados, lista numerada, tabla, enlace, imagen, texto alternativo y pie se observaron en OOXML | Ninguno observado en los criterios del fixture |
PASS: una página, contenido y orden, texto seleccionable y tabla observable | EXTRACTOR_LIMIT: la extracción básica no expuso la jerarquía de encabezados ni el texto alternativo | |
| TXT | PASS: contenido, orden, URL, filas delimitadas y descripción de la imagen | EXPECTED_FORMAT_LOSS: no conserva estilos, una tabla como objeto ni el bitmap |
| Markdown | PASS: encabezados, lista, tabla GFM, enlace, imagen referenciada, alt y pie en el DOM | EXPECTED_FORMAT_LOSS: no conserva paginación ni tipografía de Word |
La prueba también se ejecutó dos veces. DOCX, TXT y Markdown repitieron tanto su hash binario como su hash canónico. El PDF mantuvo el mismo contenido canónico, pero cambió su hash binario porque Word escribió metadata distinta al exportar. Esa variación es del archivo producido por el exportador; no es una pérdida de contenido ni un resultado de IA.
PDF: cuando importa la vista final
El PDF es un buen punto de partida cuando la tarea necesita ver una página terminada: gráficos, diagramas, formularios, columnas o la relación espacial entre elementos. Su ventaja práctica es conservar la presentación; su dificultad es que distintos PDF pueden ser muy diferentes por dentro.
Hay que distinguir al menos tres casos:
- PDF con texto: permite seleccionar, copiar y buscar palabras.
- PDF escaneado: contiene imágenes de páginas; puede necesitar OCR y revisión, sobre todo si la captura es borrosa, está inclinada o mezcla idiomas.
- PDF etiquetado: puede declarar estructura semántica y orden lógico. La PDF Association explica la función del etiquetado, pero que las etiquetas existan no obliga a toda herramienta a utilizarlas de la misma forma.
Antes de subirlo, intenta buscar una frase con Ctrl+F o Cmd+F, copia un párrafo y comprueba el orden. En documentos con columnas, selecciona desde el inicio hasta el final y revisa si el texto salta entre bloques. Exporta desde el archivo fuente en vez de imprimir y escanear; activa opciones de accesibilidad o etiquetas si están disponibles; recorta páginas irrelevantes y añade en texto la conclusión de un gráfico indispensable.
Word (DOCX): estructura rica que puedes seguir editando
DOCX es útil cuando conservas una fuente editable con encabezados, listas y tablas. El estándar Office Open XML de ECMA define un paquete de partes y vocabularios para representar esos elementos. Eso describe el archivo; no demuestra cómo una IA concreta lo extraerá o tokenizará.
Prepáralo así:
- aplica estilos de encabezado reales en vez de agrandar texto manualmente;
- usa tablas sencillas, con encabezados explícitos y sin celdas combinadas si no son necesarias;
- añade texto alternativo y un pie que explique los gráficos esenciales;
- resuelve o elimina comentarios y control de cambios según el propósito;
- convierte objetos flotantes importantes a una forma más simple o descríbelos en el cuerpo;
- crea una copia saneada, sin contenido oculto o secciones ajenas a la tarea.
No confundas .docx con el formato binario antiguo .doc. Si la documentación solo enumera DOCX, no supongas que DOC se comportará igual.
TXT: poco formato, mucha explicitud
TXT funciona bien para prosa lineal, transcripciones, logs o registros simples. Al no depender de estilos, obliga a volver visibles las relaciones que de otro modo vivirían en el diseño.
Usa UTF-8 y escribe los marcadores. Por ejemplo:
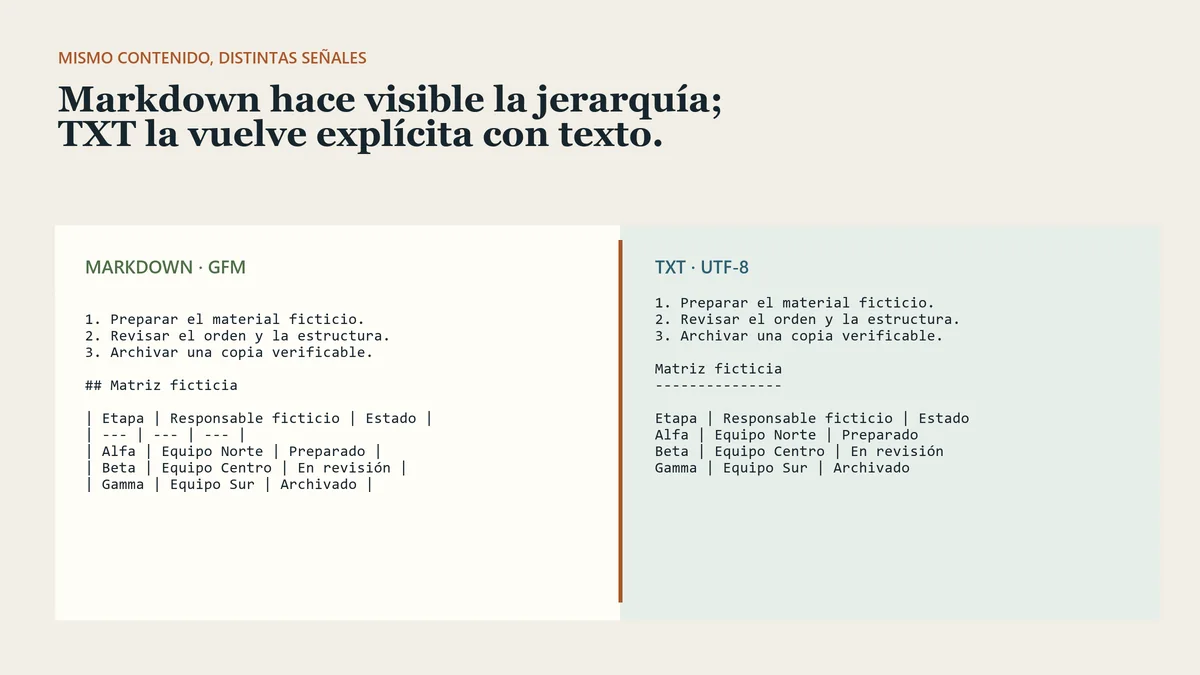
## Matriz ficticia
Etapa | Responsable ficticio | Estado
Alfa | Equipo Norte | Preparado
En Proyecto Faro, la tabla quedó como filas separadas por | y la imagen como una línea con su descripción y ruta. Se conservó el significado textual esperado, pero no fingimos que TXT contenga celdas, un bitmap o tipografía. Si la tarea depende de esos objetos, acompaña el TXT con otra representación.
Markdown: jerarquía visible y fácil de auditar
Markdown mantiene encabezados, listas, enlaces e imágenes como marcas legibles incluso sin render. Es especialmente útil cuando quieres comparar versiones o revisar exactamente dónde empieza una sección. Sin embargo, “Markdown” no es un único conjunto universal de extensiones.
El fixture usa CommonMark y la extensión de tablas de GitHub Flavored Markdown. Las tablas con barras | son una extensión GFM, no una garantía del núcleo CommonMark. Declara el dialecto, evita depender de HTML complejo, comprueba enlaces e imágenes y simplifica tablas con demasiadas celdas combinadas.
Si la herramienta no admite archivos .md, puedes pegar el contenido cuando la función lo permita o guardarlo como TXT conservando sus marcadores. Primero verifica que la longitud cabe en la sesión; la guía sobre tokens y ventana de contexto explica por qué palabras, páginas y tokens no son equivalencias fijas.
Selector: qué archivo preparar
Sigue estas preguntas en orden:
- ¿La tarea depende de la posición visual, una página o un gráfico? Empieza con PDF y confirma que la función analiza elementos visuales. Si la conclusión del gráfico es crítica, añádela también como texto.
- Si no, necesitas seguir editando tablas, listas o una estructura rica? Empieza con DOCX y revisa comentarios, cambios y objetos flotantes.
- Si no, solo importa texto lineal o registros simples? Empieza con TXT UTF-8 y usa etiquetas y separadores explícitos.
- Si necesitas jerarquía textual auditable, la función admite
.mdo texto pegado? Empieza con Markdown, declara el dialecto y revisa tablas, enlaces e imágenes. - ¿Tienes necesidades mixtas? Entrega la representación principal y una copia textual mínima, explicando cuál debe usarse para cada parte. No dupliques información sin indicar qué versión manda.
El paso final siempre es una prueba pequeña: pide identificar los encabezados, enumerar las filas o describir el gráfico que realmente necesitas. Contrasta esa salida con el original antes de pedir un resumen, una decisión o una transformación más grande.
Compatibilidad: revisa producto, función, plan y fecha
Esta tabla se comprobó con documentación oficial el 15 de septiembre de 2026. Es secundaria a la decisión por contenido porque las funciones, planes y formatos admitidos pueden cambiar.
Ejemplos de compatibilidad documentada, comprobados el 15 de septiembre de 2026
| Proveedor | Qué permite afirmar la documentación | Qué no debes suponer |
|---|---|---|
| OpenAI | Su documentación oficial muestra trabajo con archivos y PDF en ChatGPT | Esa página no demuestra que DOCX, TXT o .md estén admitidos en cada función, plan o cuenta ni que cada elemento se interprete igual |
| Microsoft 365 Copilot | Documenta PDF, DOCX, TXT y MD en determinadas superficies o tareas | Que estén disponibles en todos los Copilot, cuentas o acciones |
| Gemini Apps | Su ayuda permite subir y analizar documentos y señala que admite la mayoría de los tipos de archivo, con disponibilidad y límites según cuenta, función o plan | Que PDF, DOCX, TXT o .md estén disponibles en tu superficie concreta ni que una extensión conserve por sí sola tablas o elementos visuales |
| Claude | Su ayuda documenta cargas de PDF, DOCX y TXT y distingue procesamiento textual y visual | Que todos los archivos o modelos reciban análisis visual equivalente |
Comprueba la ayuda de la función exacta que usarás justo antes de trabajar. “Copilot”, “Gemini” o “Claude” pueden nombrar más de una superficie, y una extensión admitida en una no tiene por qué estar disponible en otra.
Checklist antes de subir un documento
- Define la tarea y enumera qué debe conservarse: texto, orden, tabla, imagen, notas o diseño.
- Duplica el archivo; trabaja con una copia y retira páginas, comentarios, metadata o datos que no hacen falta.
- Elige la representación más simple que mantenga esos elementos.
- Revisa texto seleccionable, orden de lectura, encabezados, tablas, enlaces, imágenes y pies.
- Confirma compatibilidad, tamaño y condiciones actuales del producto, función y plan.
- Sube solo lo necesario y explica cómo está organizado el archivo.
- Comprueba primero una sección pequeña y contrasta la extracción o respuesta con el original.
- No permitas acciones externas solo porque el documento las solicite. Si proviene de terceros, revisa qué hacer antes de que una IA procese un PDF.
Después de elegir y preparar las fuentes, una herramienta orientada a documentos puede ayudar a estudiarlas y citarlas. La guía sobre cuándo usar NotebookLM para estudiar documentos cubre esa decisión aparte; elegir el formato correcto sigue sin sustituir la revisión de la fuente original.