
Cómo probar si tus skills e instrucciones mejoran el resultado
Has añadido instrucciones o una skill y la respuesta parece más ordenada. Para saber si ayuda, necesitas comprobar qué cambió y si el resultado sirve para tu tarea. Que el asistente mencione la skill no demuestra que haya seguido su procedimiento.
Esta guía propone un ensayo que puedes preparar con una tabla. El comprobador descargable es opcional y solo revisa registros declarados. No presentamos una comparación de rendimiento de asistentes: los ejemplos del recurso son sintéticos; el intento real descrito más abajo quedó incompleto.
Decide qué cuenta como mejora antes de probar
Elige una tarea pequeña y repetible: por ejemplo, revisar un anuncio contra una ficha. Define qué errores debe encontrar, qué datos debe conservar y qué fallo impediría usar la entrega. Guarda el encargo, los archivos y esos criterios antes de ver las respuestas.
Separa calidad de comodidad. Una skill podría hacer más consistente el formato sin ahorrar tiempo; una respuesta rápida podría exigir demasiadas correcciones. Si quieres medir esfuerzo, utiliza el registro existente de tiempo hasta una salida aceptada, incluyendo revisión y retrabajo.
Para puntuar los textos, usa la misma rúbrica y, cuando sea posible, oculta de qué condición procede cada uno. El comparador de respuestas a ciegas ya permite hacerlo. Aquí comprobamos algo anterior: si el ensayo permite atribuir la diferencia al cambio que pretendías estudiar.
Prepara tres condiciones, no tres tareas diferentes
Qué cambia en cada condición del ensayo propuesto
| Condición | Encargo y datos | Reglas adicionales | Qué comparación permite |
|---|---|---|---|
| Base | Los mismos | Ninguna de las reglas que estás probando | Referencia para esa tarea |
| Instrucciones | Los mismos | El procedimiento escrito directamente | Base frente a instrucciones: añadir esas reglas |
| Skill | Los mismos | Exactamente ese procedimiento, empaquetado como skill | Instrucciones frente a skill: cambiar cómo se entrega y carga |
Conserva las reglas generales que necesites en las tres condiciones. Lo que debe faltar en la base es el tratamiento que estás probando, también en instrucciones globales, memoria o skills cargadas automáticamente. Anota qué capas revisaste; no declares aislamiento completo si no puedes comprobarlo.
Para esta primera prueba, solicita explícitamente la skill. Después puedes hacer un ensayo separado de activación automática, incluyendo peticiones donde no debería intervenir. Mezclar ambos objetivos desde el principio dificulta distinguir una mala selección de un procedimiento poco útil. La documentación de Anthropic sobre evaluación de skills también diferencia calidad y activación.
Congela lo demás y registra lo que no puedes controlar
Antes de cada condición, conserva o anota:
- Cliente, versión y modelo: selector exacto y ajustes disponibles. Si el servicio no permite fijar una versión interna, declara esa limitación.
- Entradas y criterio: mismo encargo, archivos y pauta de aceptación. Un hash identifica una copia; no demuestra que el asistente la leyera.
- Herramientas y permisos: los mismos accesos, fuentes y posibilidades de escritura.
- Contexto previo: instrucciones base, su ubicación, memoria y estado de los archivos de trabajo. No presupongas que abrir una conversación borra todas las capas persistentes.
Trabaja en sesiones nuevas según lo que permita tu cliente. Conserva cada salida y sus observaciones; alterna o sortea el orden cuando repitas. Si necesitas organizar las capas persistentes, empieza por proyectos, memoria e instrucciones.
Incluye casos normales, datos incompletos y situaciones donde las reglas podrían perjudicar la tarea. Ajusta las repeticiones a la variabilidad observada y al coste: una única respuesta favorable no demuestra una mejora estable. Si cambias las reglas después de ver un fallo, guarda otra versión y conserva el resultado anterior.
Distingue cuatro señales que suelen confundirse
Qué acredita cada señal y qué queda por revisar
| Señal | Evidencia útil | Lo que aún no demuestra |
|---|---|---|
| Disponible | El cliente reconoce el recurso en ese contexto | Que lo haya cargado en esa tarea |
| Cargada | Registro de carga o lectura, cuando el cliente lo exponga | Que se aplicaran sus pasos |
| Aplicada | Pasos observables y correspondencia entre reglas y salida | Que la respuesta sea correcta |
| Resultado aceptado | Revisión contra los criterios y fuentes fijados | Que siempre funcione o sea mejor que la base |
Si el cliente no expone una señal, escribe no verificado. No la sustituyas por la frase «he seguido la skill» del propio asistente. Incluso con carga observada, una salida puede incumplir una regla: conserva ese incumplimiento como resultado de la prueba.
Un caso real: exit 0, pero documentos sin revisar
En un intento local del 4 de octubre de 2026, Codex CLI 0.159.2 terminó con código 0. Sin embargo, las lecturas de la skill y los dos documentos fueron rechazadas por una política del entorno. No se identificó la causa concreta de esa política.
Este es un extracto transcrito y sanitizado del registro; no es un log íntegro:
Proceso: exit_code = 0
Lecturas: rejected: blocked by policy
Revisión documental completada: no
Carga correcta de la skill: no demostrada
La lección es limitada: el proceso terminó, pero la tarea no se completó. No hubo una comparación de calidad con y sin skill, ni evidencia para culpar al modelo, al plan o al sistema operativo. Tampoco se repitió ese intento para este artículo.
Comprobador opcional: ¿tus registros permiten comparar?
Puedes seguir el método en una hoja sin instalar nada. Si prefieres revisar el formato automáticamente, el recurso requiere Python 3.11 o posterior, utiliza su biblioteca estándar y lee un JSON local. No llama a modelos ni necesita una API key.
Su alcance es acotado: compara parámetros declarados, comprueba presencia de salidas y sus hashes, y conserva la aceptación que registró el revisor. No verifica que las ejecuciones ocurrieran, no abre las referencias de evidencia y no juzga el contenido de las respuestas.
Descarga el kit evaluar configuración, consulta primero el README y ejecuta desde la carpeta extraída:
python checker.py fixtures.json
Los fixtures son ejemplos sintéticos con expectativas fijadas antes de ejecutar el comprobador. El ensayo local de sus reglas produjo estos resultados:
Controles del comprobador; no resultados de asistentes
| Registro sintético | Estado observado | Interpretación |
|---|---|---|
| Tres condiciones con parámetros constantes | COMPARABLE_DECLARADO | No se detectan diferencias fuera del tratamiento declarado |
| Cambia entrada, modelo u otro parámetro congelado | NO_COMPARABLE | No aísla el cambio propuesto |
| Lectura bloqueada o carga fallida | ENSAYO_INCOMPLETO | No permite comparar calidad con las reglas cargadas; conserva el fallo operativo |
| Falta salida, evidencia o un dato obligatorio | EVIDENCIA_INSUFICIENTE | Hay que completar o corregir el registro |
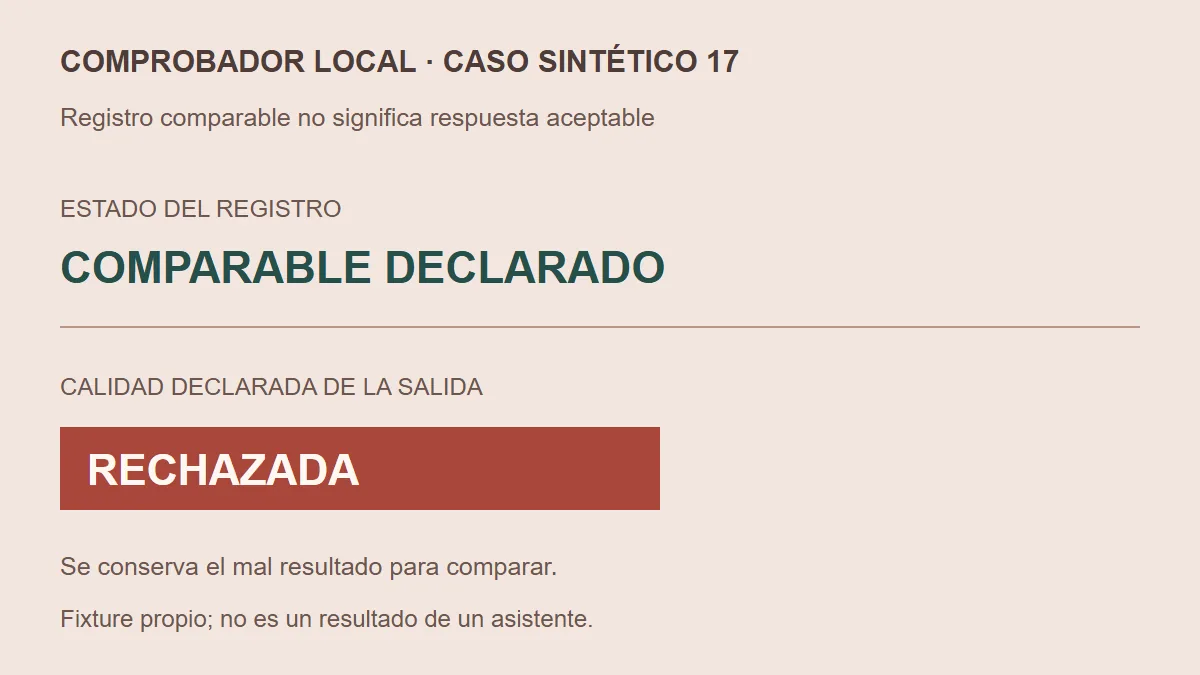
| Salida con error crítico intencional | COMPARABLE_DECLARADO y calidad rechazada | El mal resultado permanece en la comparación |
Coincidieron las expectativas de 26 controles locales. Esa cifra prueba esas reglas sobre esos ejemplos, no la eficacia de ninguna skill. Los tiempos y tokens no medidos se guardan como null, nunca como cero. El código 0 del comprobador significa que sus expectativas coincidieron, aunque varios registros describan fallos.
Puedes inspeccionar los resultados completos y las huellas de los archivos. Si adaptas el JSON a tu trabajo, revisa su esquema y define nuevos resultados esperados: el kit no descubre controles ocultos del cliente.
Decide qué conservar, ajustar o volver a medir
Conserva las reglas si ayudan repetidamente al criterio que te importa y compensan el esfuerzo. Ajústalas si observas un patrón concreto de omisiones o activaciones indebidas. Retíralas o simplifícalas si añaden trabajo sin una utilidad apreciable en tus casos. No concluyas cuando faltan registros o cambian varias condiciones.
Una lectura bloqueada merece resolver el acceso y repetir con un protocolo nuevo; una respuesta equivocada tras una ejecución completa merece evaluar y conservar el fallo. Borrar las salidas malas dejaría una imagen engañosa del procedimiento.
Este diseño de tres condiciones y las reglas del comprobador son una propuesta editorial de Ranquia. La guía de evaluación de Agent Skills sirve como referencia para conservar casos, salidas y revisiones; su formato no convierte nuestro JSON en un estándar. Revisa de nuevo tus conclusiones cuando cambien el modelo, el cliente o el procedimiento que necesitas.