Qué son los tokens y la ventana de contexto: cuánto cabe y cuánto cuesta
Por eso no es fiable convertir “128.000 tokens” en un número universal de páginas ni calcular un gasto contando palabras. La forma útil de trabajar es otra: identificar la superficie y el modelo, medir una muestra con el tokenizador correspondiente, reservar salida y aplicar las tarifas actuales del proveedor.
En esta guía puedes inspeccionar el tamaño observable de tu texto y calcular un escenario con tarifas propias en el navegador. También publicamos el corpus, los resultados y los hashes de una prueba local para que no tengas que confiar en una cifra sin metodología.
Un token no es una palabra
Un token es una unidad numérica que produce un tokenizador al dividir una entrada. Según la codificación y el texto, una pieza puede abarcar una palabra frecuente, parte de una palabra, signos o bytes que incluyen espacios. Los IDs de esas piezas solo tienen sentido junto a la codificación que los creó.
Esto tiene tres consecuencias prácticas:
- dos textos con el mismo número de palabras pueden consumir cantidades distintas;
- el mismo texto puede cambiar de recuento si cambia la codificación;
- contar caracteres o palabras sirve para orientarse, pero no sustituye una medición compatible con el modelo.
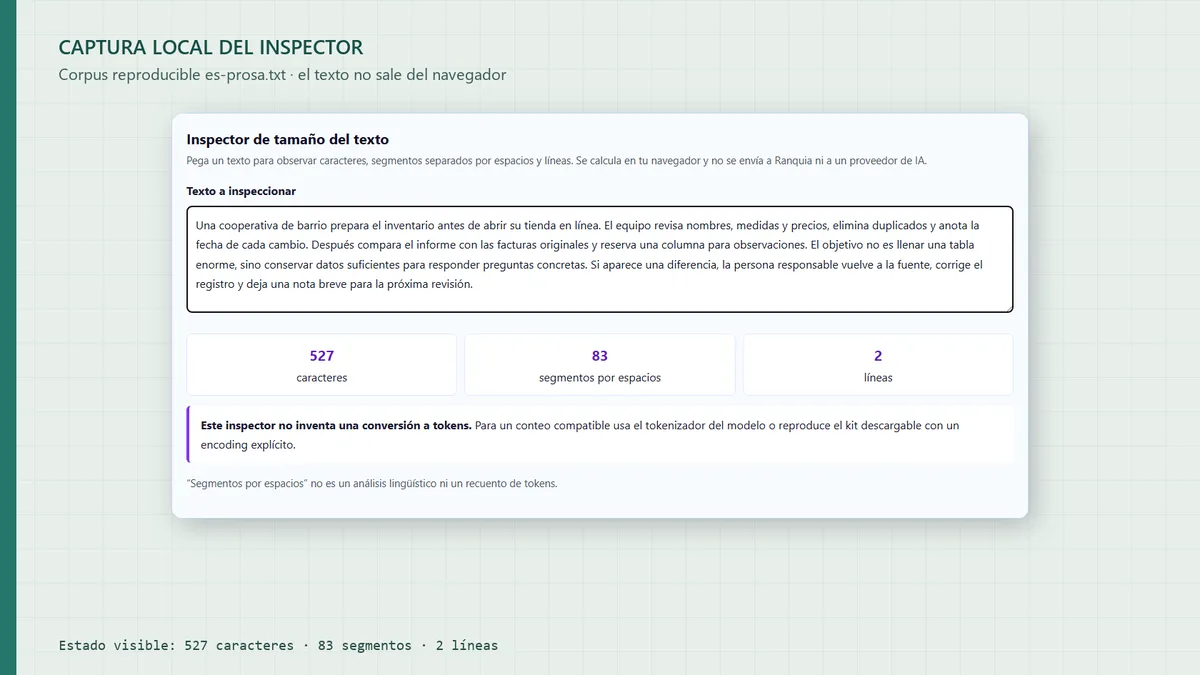
Pega un fragmento en el inspector. El cálculo ocurre en tu navegador y muestra caracteres, segmentos separados por espacios y líneas; deliberadamente no los convierte a tokens mediante una regla fija.
Inspector de tamaño del texto
Pega un texto para observar caracteres, segmentos separados por espacios y líneas. Se calcula en tu navegador y no se envía a Ranquia ni a un proveedor de IA.
Este inspector no inventa una conversión a tokens. Para un conteo compatible usa el tokenizador del modelo o reproduce el kit descargable con un encoding explícito.
“Segmentos por espacios” no es un análisis lingüístico ni un recuento de tokens.
Estas medidas sirven para comparar versiones del mismo material y detectar cuánto creció antes de volver a medirlo. No indican si un archivo cabe ni permiten presupuestar una solicitud: números, puntuación, código, idioma y tokenizador cambian el resultado, y una solicitud estructurada puede añadir información que no aparece en el texto pegado.
La prueba: el mismo corpus con dos encodings
Para comprobar cuánto cambia el recuento sin consumir una API, preparamos cuatro archivos pequeños y originales:
- una prosa en español y una traducción semánticamente alineada en inglés;
- una función de Python que calcula un coste mensual;
- un CSV con cuatro escenarios de uso.
Ejecutamos esos mismos bytes con CPython 3.11.4, tiktoken==0.14.0 y dos encodings explícitos: cl100k_base y o200k_base. No asociamos los encodings a un alias de modelo, porque esa relación puede cambiar; la prueba compara codificaciones concretas.
Recuento local del corpus de Ranquia con tiktoken 0.14.0
| Muestra | Tamaño observado | cl100k_base | o200k_base |
|---|---|---|---|
| Código Python | 718 caracteres · 76 segmentos | 167 tokens | 167 tokens |
| Prosa en inglés | 522 caracteres · 83 segmentos | 97 tokens | 97 tokens |
| Prosa en español | 527 caracteres · 83 segmentos | 121 tokens | 102 tokens |
| Tabla CSV | 209 caracteres · 5 segmentos | 80 tokens | 79 tokens |
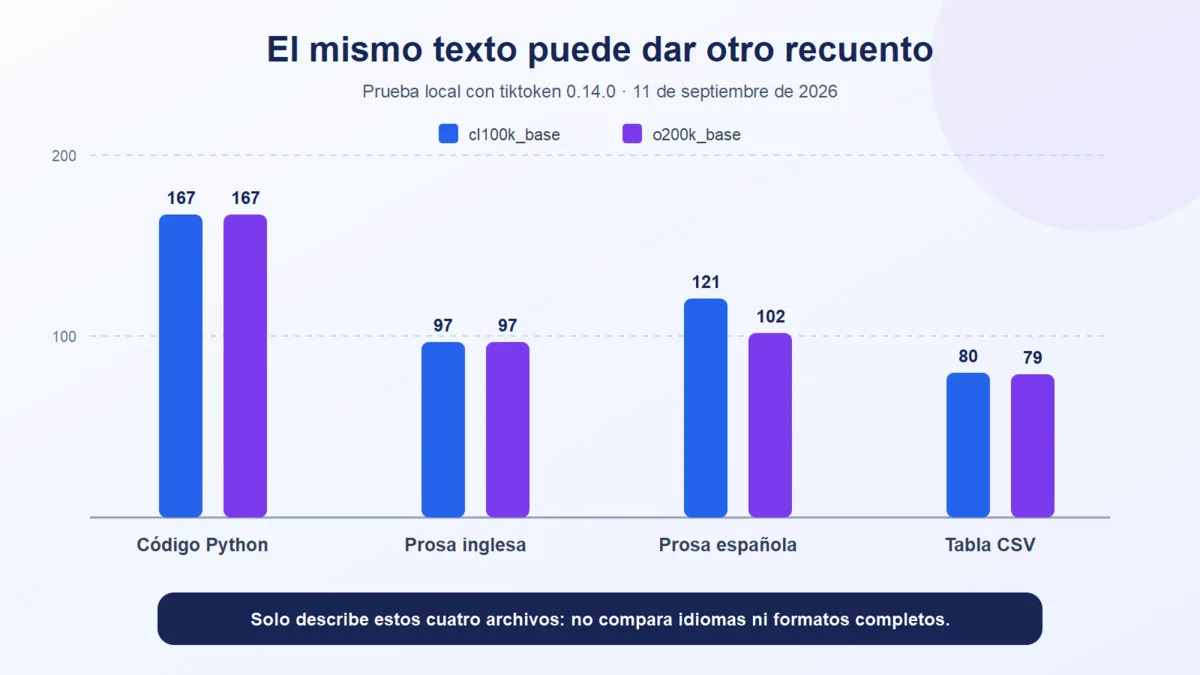
La observación más clara está en la prosa española: los mismos 531 bytes produjeron 121 tokens con cl100k_base y 102 con o200k_base. El código y la prosa inglesa dieron el mismo total bajo ambos encodings; el CSV cambió de 80 a 79.
También hay una comparación útil entre las dos prosas: ambas tienen 83 segmentos separados por espacios, pero sus totales no coinciden. Eso demuestra que str.split() y un tokenizador no están midiendo lo mismo.
Lo que la prueba no permite concluir es igual de importante. Una pareja de párrafos no representa a todos los textos en español o inglés. Tampoco demuestra que un encoding siempre sea más eficiente, que el código siempre consuma cierta proporción o que una muestra con menos tokens produzca una respuesta mejor.
Qué es la ventana de contexto
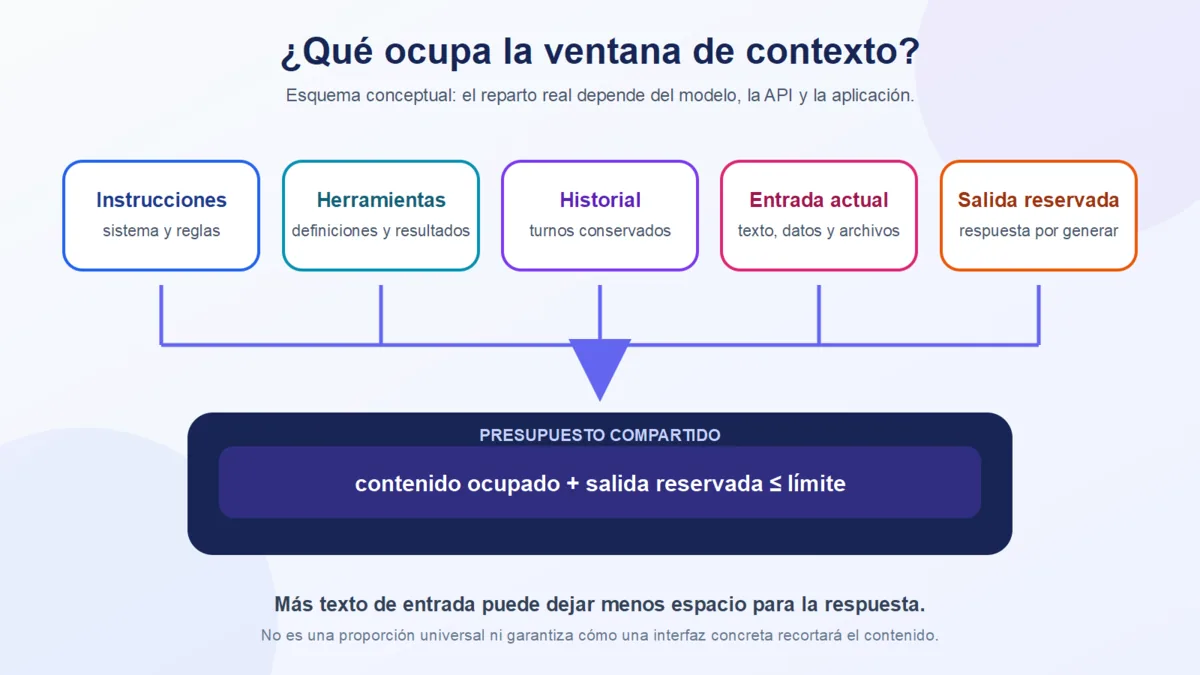
La ventana de contexto es el límite de información tokenizada que un modelo puede considerar dentro de una interacción. Es más útil pensarla como un presupuesto compartido que como la “memoria total” de una IA.
Si tu duda no es el límite de tokens sino dónde colocar archivos, reglas o preferencias dentro de ChatGPT, consulta la guía sobre proyectos, memoria e instrucciones personalizadas.
Según la superficie, dentro de ese presupuesto pueden intervenir:
- instrucciones del sistema o del desarrollador;
- definiciones y resultados de herramientas;
- mensajes anteriores que la aplicación conserva;
- la pregunta o archivo actual;
- espacio para la salida visible y, cuando corresponda, razonamiento interno;
- elementos de estructura que añade la propia solicitud.
La referencia de Responses de OpenAI documenta instrucciones, entradas de texto, imagen o archivo, herramientas, uso y un límite de salida. Anthropic explica específicamente para Claude que las instrucciones del sistema, mensajes, herramientas, imágenes, documentos y salida pueden ocupar su ventana de contexto. Esa descripción está en su documentación de ventanas de contexto.
Una ventana mayor permite presentar más información, pero no garantiza que toda reciba la misma atención ni que la respuesta sea mejor. Anthropic advierte que más contexto no es automáticamente mejor. Seleccionar lo pertinente sigue siendo parte del trabajo.
Cinco límites que no debes mezclar
Una cifra que dice “tokens” puede referirse a cosas distintas. Antes de comparar herramientas, identifica cuál de estas está midiendo.
Ventana de contexto, salida y otros límites: qué mide cada uno
| Concepto | Qué limita | Qué no debes inferir |
|---|---|---|
| Ventana de contexto | El presupuesto total que el modelo puede considerar en una interacción | Que todo ese espacio está libre para tu documento |
| Entrada disponible | Lo que queda después de instrucciones, historial, herramientas y reserva de salida | Que equivale al número publicado de la ventana |
| Salida máxima | El tope de tokens que se pueden generar en la respuesta | Que se suma siempre por fuera de la ventana |
| Rate limit | Solicitudes o tokens permitidos durante un periodo | Que indica cuánto cabe en una sola solicitud |
| Límite de archivo, mensaje o plan | Una restricción de producto o formato | Que es igual en web, app y API |
Las páginas de modelos de la API de OpenAI muestran por separado la ventana, la salida máxima, los precios y los rate limits. Esa separación es una buena señal de lectura: no traslades automáticamente una cifra de la API al chatbot web ni de un plan a otro.
Cuánto cabe: calcula un presupuesto, no páginas mágicas
Para planificar una solicitud, parte del límite documentado para el modelo y la superficie que realmente usarás. Luego resta lo que ya ocupa o debes reservar:
presupuesto restante = ventana de contexto
  − instrucciones
  − herramientas y sus resultados
  − historial conservado
  − entrada estructurada actual
  − salida reservada
  − otro overhead documentado
Imagina una ventana hipotética de 10.000 tokens. Si reservas 500 para instrucciones, 300 para herramientas, 2.000 para historial y 1.500 para salida, quedan 5.700 antes de considerar otro overhead. El ejemplo enseña la resta; no describe un modelo real.
Para saber cuánto ocupa tu material:
- extrae o copia el contenido que realmente enviarás;
- usa el tokenizador asociado al modelo, no una conversión de páginas;
- añade el historial y la estructura que corresponda;
- deja margen para la respuesta;
- si trabajas con Responses, contrasta la estimación con el endpoint oficial de conteo de tokens de entrada.
Ese último contador puede representar una entrada de Responses. Nuestro kit, en cambio, mide solo texto plano. No cuenta automáticamente roles, límites de mensajes, herramientas, esquemas, imágenes o archivos de una solicitud real.
Cuánto cuesta: separa entrada, caché y salida
No hay un coste universal por token. El precio puede depender de proveedor, modelo, superficie, fecha, categoría de uso y funciones adicionales. Incluso dentro de una misma API, una página de modelos puede mostrar tarifas distintas para entrada, entrada en caché y salida.
Si primero necesitas decidir qué producto debes presupuestar, empieza por la comparación entre ChatGPT Plus y la API.
La calculadora usa las tarifas que tú copies desde la documentación vigente. Sus valores numéricos iniciales son un ejemplo matemático, no precios de una marca; no muestra un total hasta que identifiques proveedor, modelo o superficie, URL oficial y fecha de verificación.
Calculadora de coste con tus tarifas
Copia de la documentación del proveedor los tokens mensuales y las tarifas por un millón. Para que el escenario sea auditable también debes identificar proveedor, modelo, fuente y fecha. El cálculo se realiza en tu navegador y no guarda los valores.
Faltan proveedor, modelo, URL oficial o fecha de verificación.
Los valores iniciales son solo un ejemplo matemático, no tarifas vigentes. La cifra excluye impuestos, herramientas, imágenes, audio, almacenamiento, escritura de caché, contexto largo y cualquier otra unidad que cobre el proveedor.
La fórmula base, cuando el proveedor define la entrada cacheada como un subconjunto de la entrada total, es:
entrada no cacheada = entrada total − entrada cacheada

coste = (entrada no cacheada × tarifa de entrada
       + entrada cacheada × tarifa de caché
       + salida × tarifa de salida)
       ÷ unidad de precio
Antes de aceptar el resultado, confirma:
- si las tarifas están expresadas por mil, millón u otra unidad;
- si
cached_input_tokensforma parte del total de entrada o viene informado aparte; - si el uso de razonamiento ya está incluido en los tokens de salida;
- si existen cargos por escritura de caché, búsqueda, herramientas, almacenamiento, imagen o audio;
- moneda, impuestos, modo de procesamiento y fecha de verificación.
Por ejemplo, la referencia de OpenAI define max_output_tokens como un máximo que incluye salida visible y tokens de razonamiento, y el objeto usage presenta detalles de entrada y salida. No sumes una categoría dos veces por interpretar campos sin revisar su definición.
Si quieres ver una aplicación con tarifas fechadas y categorías separadas, consulta la guía de precio de la API de DeepSeek en Latinoamérica. Usa aquella página para verificar su proveedor; usa esta para entender la mecánica.
Qué ocurre cuando el contenido no cabe
No existe una conducta idéntica para todos los productos. Una aplicación puede rechazar la solicitud, retirar mensajes antiguos, compactar el historial o imponer antes otro límite de archivo o plan.
La referencia actual de Responses todavía describe dos comportamientos para truncation, pero marca ese parámetro como deprecado: con disabled, una entrada que supera la ventana falla; con auto, la API puede retirar elementos del comienzo de la conversación para ajustarla. Se menciona para interpretar integraciones existentes, no como recomendación de diseño futuro, y sigue siendo una conducta específica de esa API, no una regla de todos los chats.
Si estás cerca del límite, prueba en este orden:
- elimina repetición: instrucciones duplicadas, ejemplos irrelevantes y versiones antiguas;
- divide por una unidad lógica: capítulos, periodos, módulos o grupos de filas;
- resume con trazabilidad: conserva enlaces, IDs o referencias para volver al original;
- recupera solo lo pertinente: usa búsqueda o RAG cuando el corpus completo no necesita estar presente;
- abre una conversación limpia con un resumen controlado: no arrastres historial por costumbre.
Si trabajas con archivos largos y fuentes, la guía de NotebookLM para estudiar documentos explica cuándo conviene una herramienta centrada en documentos. Para ejecutar y ajustar el contexto en tu propio equipo, revisa cómo usar LLMs locales.
Descarga y reproduce el experimento
El kit no requiere una clave ni realiza llamadas a modelos. Incluye corpus, scripts, lock de dependencias, resultados detallados, una calculadora local, pruebas y un manifest de integridad.
- Descargar el kit completo en ZIP.
- Abrir los resultados en CSV.
- Abrir los resultados en JSON.
- Revisar las piezas e IDs en JSON.
- Verificar el manifest SHA-256.
- Leer las instrucciones completas.
La corrida canónica usa tiktoken==0.14.0, cl100k_base, o200k_base, CPython 3.11.4 y archivos UTF-8 con saltos LF. El manifest del kit generado para esta guía tiene SHA-256 8aac6e7e1c3098e62c159b8c6e0c6d462fdf37e40412cc44eae9019d54bcd3c5.
El bootstrap es el único paso que puede necesitar red para preparar dependencias y datos del tokenizador. Después, conteo, cálculo y pruebas se ejecutan localmente. La suite verificó ocho filas, round-trip de todos los textos, paridad JSON/CSV, cálculo decimal, ejecución sin red después del bootstrap y dos builds con el mismo manifest.
Checklist antes de confiar en una cifra
- ¿La cifra identifica proveedor, modelo, plan y superficie?
- ¿El conteo indica tokenizador, versión o encoding?
- ¿Distingue texto plano de una solicitud completa?
- ¿Reserva salida y considera historial/herramientas?
- ¿Separa ventana, salida máxima, rate limits y límites de archivos?
- ¿Las tarifas tienen moneda, unidad, fuente y fecha?
- ¿La conclusión está limitada a la muestra que se midió?
Si una tabla dice cuántas “páginas” caben pero no explica idioma, formato, extracción, tokenizador, salida reservada y fecha, úsala solo como orientación. Si una calculadora no separa categorías o no enlaza la tarifa, no la uses para decidir un presupuesto.
Fuentes y alcance
Fuentes de producto consultadas el 11 de septiembre de 2026:
- Modelos de la API de OpenAI.
- Referencia de Responses: crear una respuesta.
- Referencia de Responses: contar tokens de entrada.
- Tokenizador visual de OpenAI Platform.
- Ventanas de contexto de Claude.
Las afirmaciones sobre Claude están atribuidas a su documentación. Los resultados de tiktoken son evidencia reproducible del kit local de Ranquia, no límites, precios ni resultados de calidad de un producto comercial.