Cómo comparar dos respuestas de IA sin dejarte convencer por el tono
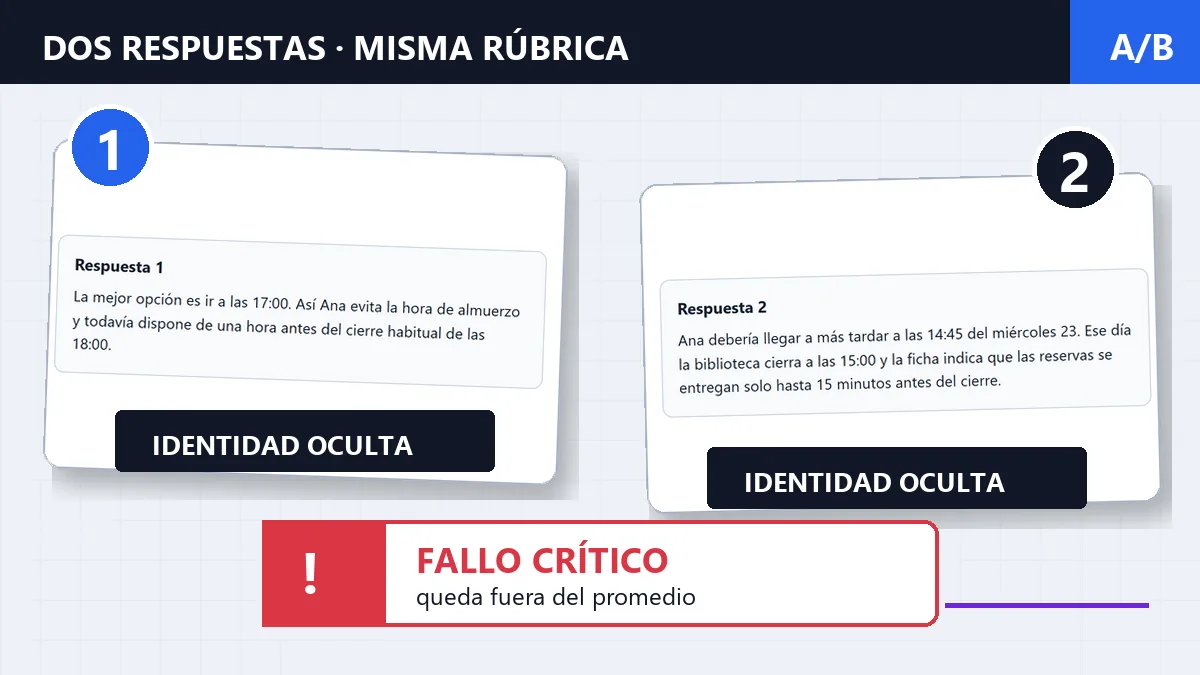
Reto a ciegas: ¿cuál respuesta usarías?
Lee este caso completamente ficticio y elige una respuesta antes de conocer su nombre. No hay marcas ni modelos reales detrás del ejemplo.
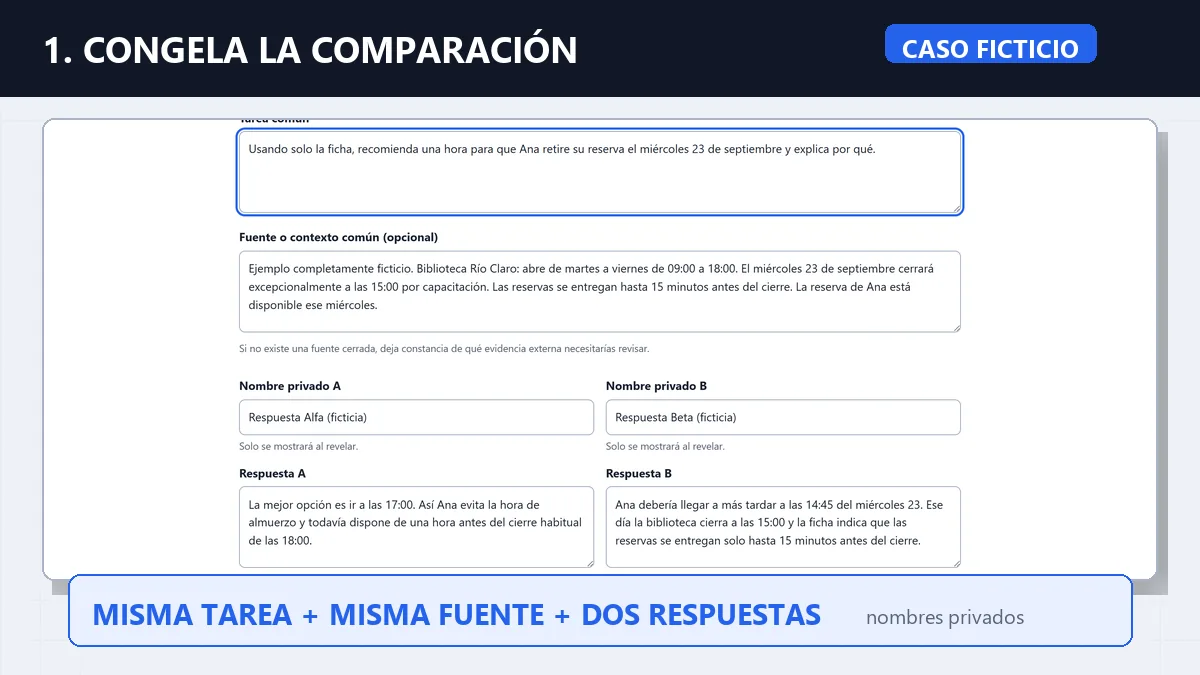
Tarea: Usando solo la ficha, recomienda una hora para que Ana retire su reserva el miércoles 23 de septiembre y explica por qué.
Ficha: Ejemplo completamente ficticio. Biblioteca Río Claro: abre de martes a viernes de 09:00 a 18:00. El miércoles 23 de septiembre cerrará excepcionalmente a las 15:00 por capacitación. Las reservas se entregan hasta 15 minutos antes del cierre. La reserva de Ana está disponible ese miércoles.
Respuesta X
La mejor opción es ir a las 17:00. Así Ana evita la hora de almuerzo y todavía dispone de una hora antes del cierre habitual de las 18:00.
Respuesta Y
Ana debería llegar a más tardar a las 14:45 del miércoles 23. Ese día la biblioteca cierra a las 15:00 y la ficha indica que las reservas se entregan solo hasta 15 minutos antes del cierre.
¿Cuál elegirías? Guarda tu respuesta mental. La revelación está más abajo, pero lo importante no es acertar por intuición: es poder explicar la decisión con la ficha.
Comparar dos respuestas de IA a ciegas: usa la herramienta
Pega el encargo, la fuente de referencia y las dos respuestas. Los nombres que escribas en “origen” permanecen ocultos mientras puntúas. El comparador mezcla el orden, exige una nota de evidencia en cada criterio activo, calcula una media según los pesos que tú configures y mantiene los fallos críticos separados del promedio.
Comparador ciego de dos respuestas de IA
Pega la misma tarea y el mismo contexto para ambas respuestas. El comparador sortea su orden, te guía por una rúbrica y conserva los nombres ocultos hasta que cierres tu decisión.
Cómo funciona: todo se procesa en este navegador; no llama a modelos, no juzga automáticamente si algo es verdadero y no envía ni almacena tus textos. El orden aleatorio reduce algunas señales de identidad y posición, pero no elimina todos los sesgos.
Evaluación sin nombres
Puntúa de 1 (no cumple) a 5 (cumple muy bien) y anota la evidencia que justifica la diferencia.
Primera pasada: evalúa el orden sorteado sin intentar adivinar el origen.
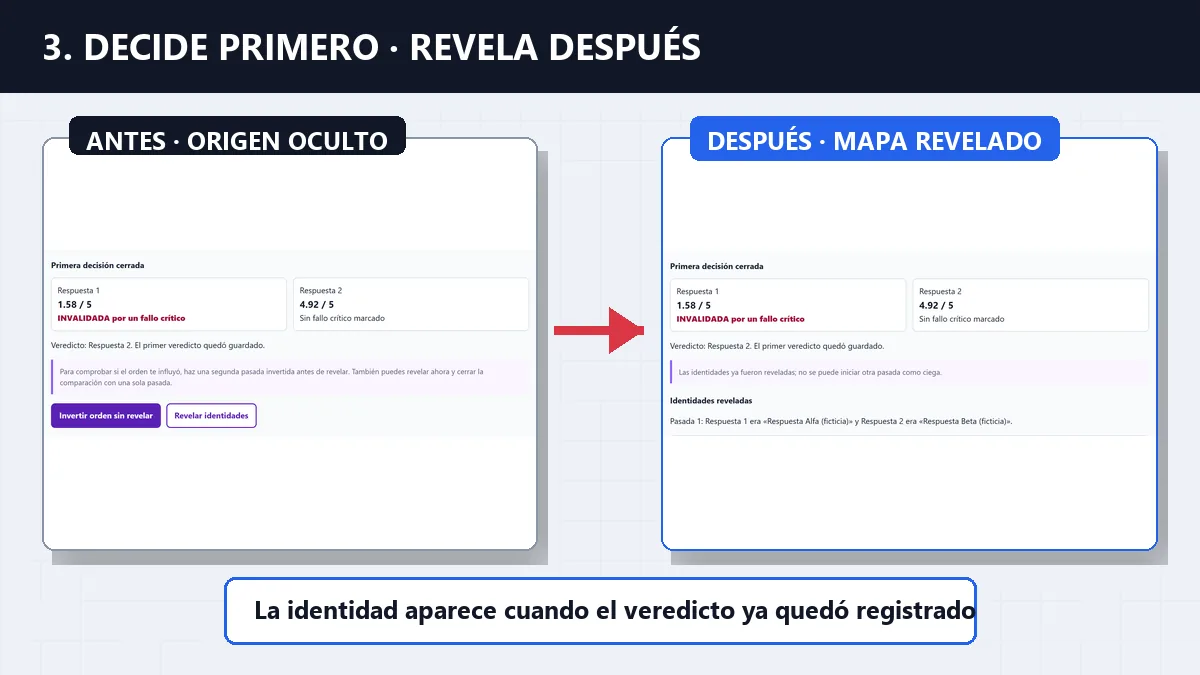
Decisión cerrada
Para comprobar si el orden te influyó, haz una segunda pasada invertida antes de revelar. También puedes revelar ahora y cerrar la comparación con una sola pasada.
Identidades reveladas
Si prefieres usarlo fuera de Ranquia, tienes estas descargas:
- abrir el comparador HTML autocontenido;
- descargar el kit completo en ZIP;
- revisar el caso ficticio en JSON;
- consultar el manifest de versión y archivos y sus huellas SHA-256.
El comparador no decide cuál texto es verdadero. La evaluación es manual: tú debes contrastar cada afirmación con la fuente disponible. Tampoco convierte este duelo en una clasificación general de los modelos que produjeron las respuestas.
El método en seis pasos
- Congela la tarea. Usa el mismo encargo, audiencia, fuente, restricciones y formato esperado para ambas respuestas.
- Define la rúbrica. Decide qué significa cumplir antes de leer y asigna más peso solo a lo que realmente cambia la decisión.
- Oculta el origen. Guarda los nombres por separado y trabaja con Respuesta 1 y Respuesta 2 en un orden sorteado.
- Puntúa y documenta. Revisa cada criterio y anota el fragmento de la respuesta o de la fuente que justifica tu nota.
- Aplica los fallos críticos. Una contradicción decisiva no desaparece porque el texto sea claro o consiga una media alta.
- Cierra, invierte y revela. Registra primero tu decisión. Si es importante, repite con el orden cambiado; revela el origen solo al final.
Este orden es una decisión editorial de Ranquia, no un estándar universal ni un procedimiento atribuido a NIST, Chatbot Arena o los estudios citados. Su objetivo es separar señales que suelen mezclarse: contenido, evidencia, presentación y procedencia.
Congela la tarea antes de mirar las respuestas
Dos textos no son comparables si uno recibió más contexto, otra fuente o una instrucción materialmente distinta. Antes de abrirlos, anota:
- el encargo exacto;
- a quién va dirigida la salida;
- la fuente o los datos contra los que comprobarás los hechos;
- el formato y las restricciones no negociables;
- qué omisión o error volvería inútil el resultado;
- qué quedará fuera de la comparación.
Si una respuesta usó búsqueda web y la otra solo un documento cerrado, puedes compararlas como entregables, pero debes registrar esa diferencia. No la conviertas en una conclusión sobre “qué modelo es mejor”. Si la tarea depende de un archivo, primero conviene preparar el PDF, Word, TXT o Markdown para que conserve la información necesaria.
En tareas abiertas quizá no exista una fuente que permita declarar una única respuesta correcta. En ese caso, separa los requisitos comprobables de las preferencias y permite evidencia insuficiente como resultado. Una opinión bien explicada sigue siendo una opinión; una puntuación no la transforma en hecho.
Qué logra —y qué no— ocultar el origen
La comparación anónima por pares se usa en evaluaciones reales. Chatbot Arena describe un modo de batalla en el que se muestran dos modelos anónimos y la identidad se revela después del voto; su paper de ICML 2024 explica la evaluación por preferencias humanas.
Ese patrón respalda una acción concreta: posponer la marca hasta haber decidido. No demuestra que un voto identifique la verdad ni que una comparación individual produzca un ranking fiable.
El cegamiento tampoco borra las pistas del texto. Longitud, formato, expresiones recurrentes o una advertencia característica pueden sugerir el origen. Además, un estudio con tres experimentos publicado en Findings of ACL 2025 observó que las etiquetas “humano” e “IA” alteraron las preferencias de sus participantes. El alcance importa: no permite estimar qué ocurrirá con tu tarea, tu idioma o tu experiencia; sí recuerda que la etiqueta puede contaminar el primer juicio.
Por eso el comparador reduce una señal visible —el nombre— y registra el orden. No elimina todos los sesgos.
Puntúa cada respuesta por separado
Lee primero la Respuesta 1 y decide qué tan bien satisface cada criterio sin usar la Respuesta 2 como referencia. Luego repite el proceso con la Respuesta 2. Solo después mira las diferencias.
Esta separación ayuda a que “suena mejor que la otra” no sustituya preguntas más útiles:
- ¿cumple exactamente el encargo?;
- ¿qué afirmación se puede rastrear a la fuente?;
- ¿qué punto importante omitió?;
- ¿la entrega se puede usar o requiere rehacerla?;
- ¿el tono era un requisito o solo una primera impresión agradable?
La recomendación de evaluar primero por criterios y comparar después es un diseño prudente de esta guía. Los hallazgos técnicos no se trasladan automáticamente a toda persona: en experimentos con jueces LLM, Zheng y colaboradores documentaron sesgos de posición, verbosidad y auto-preferencia, mientras otro trabajo sobre comparación directa estudió cómo el tono autoritativo y la verbosidad pueden influir en esos evaluadores automáticos. Son resultados sobre sistemas y conjuntos concretos, no una medida de tu sesgo personal.
Cómo adaptar la rúbrica a tu tarea
El comparador parte de una escala de 1 a 5 y permite ponderar cada criterio de 1 a 3. Es una rúbrica configurable de Ranquia, no una norma técnica. Antes de puntuar, define qué representa un 1, un 3 y un 5 en tu caso para no mover el criterio después de ver quién parece ganar.
Criterios iniciales del comparador y evidencia útil
| Criterio | Qué pregunta | Evidencia que conviene anotar |
|---|---|---|
| Cumplimiento de la tarea | ¿Respeta el encargo, el público y el formato? | Requisito exacto y fragmento que lo cumple o incumple |
| Corrección frente a la fuente | ¿Las afirmaciones importantes coinciden con la referencia? | Fragmento de la fuente y afirmación de la respuesta |
| Cobertura de lo importante | ¿Incluye lo indispensable sin ocultarlo entre relleno? | Checklist del encargo y omisión observada |
| Evidencia y trazabilidad | ¿Permite reconstruir de dónde sale la conclusión? | Cita, dato, cálculo o referencia verificable |
| Claridad y formato | ¿Se entiende y sirve al público previsto? | Pasaje concreto; no basta con “suena profesional” |
| Esfuerzo de corrección | ¿Está casi lista o hay que rehacerla? | Cambios necesarios hasta llegar a una salida aceptable |
El tono puede ser central en un mensaje a un cliente y secundario en una extracción factual. La claridad también importa, pero no debe compensar un dato inventado. Cambia pesos según la tarea y explica el motivo: una suma sin anclas solo da apariencia de precisión.
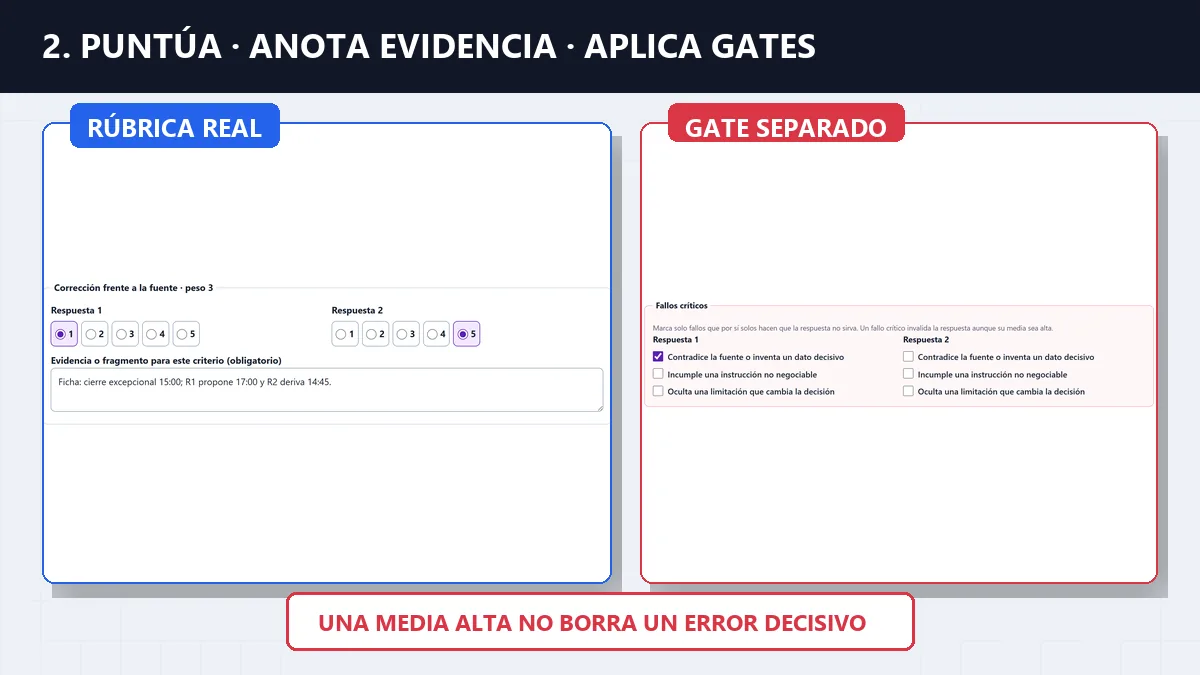
Un fallo crítico está fuera del promedio
En la herramienta puedes marcar tres gates por respuesta:
- contradice la fuente o inventa un dato decisivo;
- incumple una instrucción no negociable;
- oculta una limitación que cambia la decisión.
Un gate marcado invalida esa respuesta aunque sus demás puntuaciones sean altas. Esta también es una regla editorial del comparador, no un umbral científico. Debes definir “crítico” según el uso: no lo emplees para castigar una preferencia de estilo.
El promedio sirve para resumir criterios con pesos distintos, pero no responde por sí solo cuál salida debes usar. Conserva a la vista las notas, los fallos y las correcciones pendientes. Si no puedes comprobar una afirmación que cambia la decisión, registra evidencia insuficiente en vez de premiar la seguridad con que está escrita.
Un empate también es válido. Puede significar que ambos textos son utilizables, que fallan de maneras diferentes o que no tienes base para separarlos. En los dos últimos casos, describe por qué: “empate” y “no sé todavía” no son lo mismo.
Invierte el orden cuando la decisión importa
Después de cerrar la primera evaluación, puedes repetir con las mismas respuestas en posiciones opuestas. No cambies el encargo, la fuente, los criterios ni el texto entre una pasada y otra. La herramienta guarda el primer veredicto y ofrece Invertir orden sin revelar; si revelas después de una sola pasada, cierra la opción de iniciar otra como ciega.
Si mantienes el veredicto y la evidencia, tienes una decisión más estable para ese caso. Si cambia, registra inconcluso por orden y conserva ambos informes. La segunda pasada no corrige mágicamente el sesgo: hace visible una discrepancia que un único orden habría ocultado.
Los estudios de jueces LLM han encontrado que la dirección y la intensidad del sesgo de posición varían por evaluador y tarea; el trabajo Judging the Judges es una referencia específica sobre ese fenómeno. No uses su magnitud como estimación del comportamiento humano. Aquí invertir sirve como comprobación diagnóstica, no como garantía.
Revelación del caso de la Biblioteca Río Claro
En el reto inicial, la Respuesta X era la Respuesta Alfa ficticia y la Respuesta Y era la Respuesta Beta ficticia. No corresponden a productos reales.
La Respuesta Alfa fluye bien, pero recomienda las 17:00 usando el cierre habitual de las 18:00. La ficha dice que ese miércoles la biblioteca cierra excepcionalmente a las 15:00 y que las entregas terminan 15 minutos antes. La hora propuesta queda fuera del periodo permitido: es una contradicción decisiva.
La Respuesta Beta conserva las dos restricciones y deriva las 14:45. Bajo esta tarea cerrada, tiene respaldo directo en la ficha. Eso permite preferirla en el caso, pero no demuestra que un origen sea mejor que otro: el ejemplo fue escrito para comprobar el flujo del comparador, no para medir modelos.
Si usas otra IA como juez, trátala como segundo lector
Pedirle a un tercer modelo que elija puede ayudar a localizar discrepancias, pero no reemplaza la fuente ni resuelve automáticamente el problema. Un juez automático también puede preferir una posición, una respuesta más extensa o un estilo específico, como muestran los estudios citados sobre jueces LLM.
Si aun así lo utilizas:
- conserva el mismo prompt y la misma rúbrica;
- oculta los nombres de los dos orígenes;
- exige que cite el fragmento que justifica cada nota;
- intercambia el orden y registra si cambia;
- revisa tú los gates factuales contra la fuente;
- guarda modelo, superficie y fecha, porque el comportamiento puede cambiar.
El acuerdo entre dos sistemas no convierte una afirmación en verdad. Si ambos parten de la misma información incompleta o repiten el mismo error, pueden coincidir y seguir equivocados.
Cuándo esta comparación no basta
Una pareja de respuestas resuelve una decisión puntual, no evalúa un proveedor completo. Necesitas más casos o revisión especializada cuando:
- la decisión afecta salud, finanzas, empleo, seguridad o derechos;
- no tienes una fuente ni conocimiento suficiente para detectar un error;
- comparas código, imágenes, audio o video que requieren pruebas específicas;
- la tarea es subjetiva y no existe acuerdo sobre qué significa “mejor”;
- quieres decidir una suscripción, una integración o el uso sostenido en un equipo;
- distintas personas usarán la salida y pueden valorar riesgos diferentes.
Para decidir si una suscripción resuelve tu flujo, usa una prueba de 30 minutos antes de pagar. Si necesitas observar productividad y calidad en tareas repetidas, amplía el registro con el protocolo para medir durante siete días si la IA ahorra tiempo. Son preguntas distintas a elegir entre dos textos concretos.
Método, privacidad y límites del comparador
Ranquia preparó este comparador y el fixture de la Biblioteca Río Claro el 15 de septiembre de 2026. El ejemplo, los nombres, la institución, la fecha y las respuestas son ficticios. Sirven para reproducir una contradicción verificable dentro de una fuente cerrada.
La herramienta funciona en el navegador, no llama a un modelo, no usa analítica y no guarda los textos en almacenamiento persistente. Al iniciar la comparación, elimina de los campos visibles los nombres y respuestas originales y mantiene el estado necesario en la memoria de la página hasta que reinicies o cierres. Aun así, no pegues secretos ni datos personales en una herramienta que no hayas revisado; puedes descargar el HTML, inspeccionarlo y usarlo sin conexión.
El informe exportado contiene la tarea, la fuente, el mapa revelado, la decisión, las notas, las puntuaciones y los gates registrados. Guardarlo en tu equipo sí crea una copia bajo tu control. Las huellas del kit permiten comprobar si los archivos cambiaron, no certifican que una evaluación sea correcta.
El NIST AI RMF Playbook, en su función Measure, recomienda documentar conjuntos de prueba, métricas, herramientas, procesos y materiales, atendiendo al contexto de uso. Esa orientación respalda documentar el caso y sus límites; NIST no prescribe la rúbrica de esta página ni valida sus pesos.
La conclusión correcta tiene un alcance estrecho: el método puede reducir la influencia visible de la marca, separar criterios y dejar una decisión auditable. No elimina sesgos, no prueba la verdad por sí solo y no convierte dos respuestas en un benchmark.